







 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
Nachrichtenartikel zu Kryptowährungen
Freischaltung erweiterter Sprachmodelle: Retrieval Enhanced Generation enthüllt
Apr 01, 2024 at 03:04 am
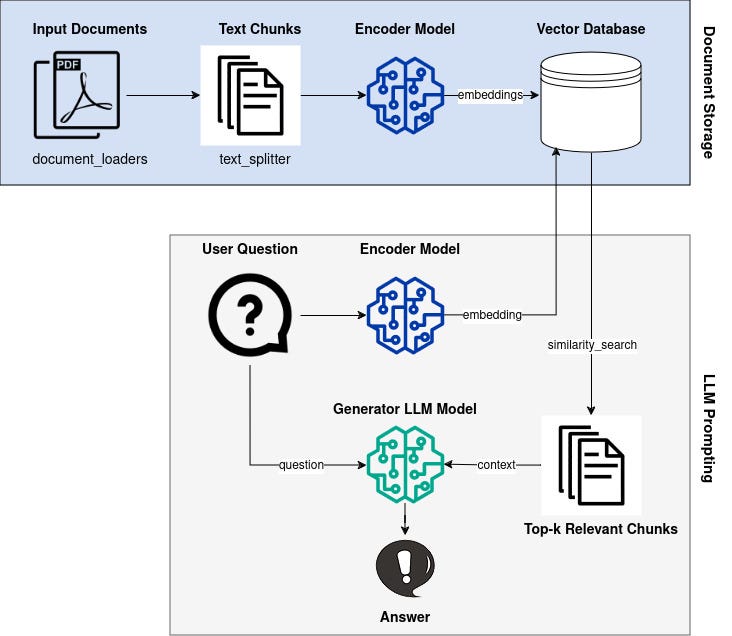
Retrieval-Augmented Generation (RAG) erweitert Large Language Models (LLMs) durch die Integration spezifischer Kenntnisse aus einer Wissensdatenbank. Dieser Ansatz nutzt Vektoreinbettungen, um relevante Informationen effizient abzurufen und den LLM-Kontext zu erweitern. RAG behebt Einschränkungen von LLMs, wie veraltetes Wissen und Halluzinationen, indem es während der Beantwortung von Fragen Zugriff auf spezifische Informationen bietet.
Introduction: Enhancing Large Language Models with Retrieval-Augmented Generation (RAG)
Einführung: Erweiterung großer Sprachmodelle mit Retrieval-Augmented Generation (RAG)
Large Language Models (LLMs) have demonstrated remarkable capabilities in comprehending and synthesizing vast amounts of knowledge encoded within their numerous parameters. However, they possess two significant limitations: limited knowledge beyond their training dataset and a propensity to generate fictitious information when faced with specific inquiries.
Large Language Models (LLMs) haben bemerkenswerte Fähigkeiten beim Verstehen und Synthetisieren großer Wissensmengen, die in ihren zahlreichen Parametern kodiert sind, bewiesen. Allerdings weisen sie zwei wesentliche Einschränkungen auf: begrenztes Wissen über ihren Trainingsdatensatz hinaus und eine Neigung, bei spezifischen Anfragen fiktive Informationen zu generieren.
Retrieval-Augmented Generation (RAG)
Retrieval-Augmented Generation (RAG)
Researchers at Facebook AI Research, University College London, and New York University introduced the concept of Retrieval-Augmented Generation (RAG) in 2020. RAG leverages pre-trained LLMs with additional context in the form of specific relevant information, enabling them to generate informed responses to user queries.
Forscher von Facebook AI Research, dem University College London und der New York University führten 2020 das Konzept der Retrieval-Augmented Generation (RAG) ein. RAG nutzt vorab trainierte LLMs mit zusätzlichem Kontext in Form spezifischer relevanter Informationen und ermöglicht es ihnen, fundierte Informationen zu generieren Antworten auf Benutzeranfragen.
Implementation with Hugging Face Transformers, LangChain, and Faiss
Implementierung mit Hugging Face Transformers, LangChain und Faiss
This article provides a comprehensive guide to implementing Google's LLM Gemma with RAG capabilities using Hugging Face transformers, LangChain, and the Faiss vector database. We will delve into the theoretical underpinnings and practical aspects of the RAG pipeline.
Dieser Artikel bietet eine umfassende Anleitung zur Implementierung von Googles LLM Gemma mit RAG-Funktionen mithilfe von Hugging Face-Transformatoren, LangChain und der Faiss-Vektordatenbank. Wir werden uns mit den theoretischen Grundlagen und praktischen Aspekten der RAG-Pipeline befassen.
Overview of the RAG Pipeline
Übersicht über die RAG-Pipeline
The RAG pipeline comprises the following steps:
Die RAG-Pipeline umfasst die folgenden Schritte:
- Knowledge Base Vectorization: Encode a knowledge base (e.g., Wikipedia documents) into dense vector representations (embeddings).
- Query Vectorization: Convert user queries into vector embeddings using the same encoder model.
- Retrieval: Identify embeddings in the knowledge base that are similar to the query embedding based on a similarity metric.
- Generation: Generate a response using the LLM, augmented with the retrieved context from the knowledge base.
Knowledge Base and Vectorization
Wissensdatenbank-Vektorisierung: Kodieren Sie eine Wissensdatenbank (z. B. Wikipedia-Dokumente) in dichte Vektordarstellungen (Einbettungen). Abfragevektorisierung: Konvertieren Sie Benutzeranfragen in Vektoreinbettungen mit demselben Encodermodell Abfrageeinbettung basierend auf einer Ähnlichkeitsmetrik. Generierung: Generieren Sie eine Antwort mithilfe des LLM, ergänzt durch den abgerufenen Kontext aus der Wissensdatenbank. Wissensbasis und Vektorisierung
We begin by selecting an appropriate knowledge base, such as Wikipedia or a domain-specific corpus. Each document z_i in the knowledge base is converted into an embedding vector d(z) using an encoder model.
Wir beginnen mit der Auswahl einer geeigneten Wissensdatenbank, beispielsweise Wikipedia oder einem domänenspezifischen Korpus. Jedes Dokument z_i in der Wissensdatenbank wird mithilfe eines Encodermodells in einen Einbettungsvektor d(z) umgewandelt.
Query Vectorization
Abfragevektorisierung
When a user poses a question x, it is also transformed into an embedding vector q(x) using the same encoder model.
Wenn ein Benutzer eine Frage x stellt, wird diese unter Verwendung desselben Encodermodells auch in einen Einbettungsvektor q(x) umgewandelt.
Retrieval
Abruf
To identify relevant documents from the knowledge base, we utilize a similarity metric to measure the distance between q(x) and all available d(z). Documents with similar embeddings are considered relevant to the query.
Um relevante Dokumente aus der Wissensdatenbank zu identifizieren, verwenden wir eine Ähnlichkeitsmetrik, um den Abstand zwischen q(x) und allen verfügbaren d(z) zu messen. Dokumente mit ähnlichen Einbettungen gelten als relevant für die Abfrage.
Generation
Generation
The LLM is employed to generate a response to the user query. However, unlike traditional LLMs, Gemma is augmented with the retrieved context. This enables it to incorporate relevant information from the knowledge base into its response, improving accuracy and reducing hallucinations.
Der LLM wird verwendet, um eine Antwort auf die Benutzeranfrage zu generieren. Im Gegensatz zu herkömmlichen LLMs wird Gemma jedoch um den abgerufenen Kontext erweitert. Dies ermöglicht es ihm, relevante Informationen aus der Wissensdatenbank in seine Reaktion einzubeziehen, was die Genauigkeit verbessert und Halluzinationen reduziert.
Conclusion
Abschluss
By leveraging the Retrieval-Augmented Generation (RAG) technique, we can significantly enhance the capabilities of Large Language Models. By providing LLMs with access to specific relevant information, we can improve the accuracy and consistency of their responses, making them more suitable for real-world applications that require accurate and informative knowledge retrieval.
Durch den Einsatz der Retrieval-Augmented Generation (RAG)-Technik können wir die Fähigkeiten großer Sprachmodelle erheblich verbessern. Indem wir LLMs Zugriff auf spezifische relevante Informationen gewähren, können wir die Genauigkeit und Konsistenz ihrer Antworten verbessern und sie so für reale Anwendungen geeigneter machen, die eine genaue und informative Wissensabfrage erfordern.
Haftungsausschluss:info@kdj.com
Die bereitgestellten Informationen stellen keine Handelsberatung dar. kdj.com übernimmt keine Verantwortung für Investitionen, die auf der Grundlage der in diesem Artikel bereitgestellten Informationen getätigt werden. Kryptowährungen sind sehr volatil und es wird dringend empfohlen, nach gründlicher Recherche mit Vorsicht zu investieren!
Wenn Sie glauben, dass der auf dieser Website verwendete Inhalt Ihr Urheberrecht verletzt, kontaktieren Sie uns bitte umgehend (info@kdj.com) und wir werden ihn umgehend löschen.
-
- Strives aufstrebendes Bitcoin-Finanzministerium: Ein New Yorker Geisteszustand für Unternehmenskrypto
- Sep 22, 2026 at 08:05 am
- Strive setzt seine starke Anhäufung von Bitcoin fort und präsentiert eine klare Strategie für das Treasury-Management von Unternehmen im digitalen Zeitalter. Dieser Schritt unterstreicht den wachsenden Trend bei Unternehmen, Krypto als Kernwert zu nutzen.
-
- Apple und Google nutzen Stablecoin-Experten und signalisieren damit einen großen Wandel in der Krypto-Zahlungsstrategie
- Sep 22, 2026 at 04:05 am
- Die Technologiegiganten Apple und Google stellen aktiv Stablecoin- und Blockchain-Spezialisten ein und signalisieren damit eine bedeutende Weiterentwicklung ihres Ansatzes für Kryptozahlungen und Finanzinfrastruktur.
-
- Ausschuss des Repräsentantenhauses bringt 20-jähriges Bitcoin-Reservegesetz voran: Ein Blick in die Zukunft digitaler Vermögenswerte Amerikas
- Sep 21, 2026 at 12:05 pm
- Ein Ausschuss des US-Repräsentantenhauses hat beschlossen, eine 20-jährige Bitcoin-Reserve und einen größeren Vorrat an digitalen Vermögenswerten einzurichten, was einen langfristigen Wandel in der Kryptopolitik des Bundes signalisiert.
-
- Das US-Finanzministerium verurteilt die iranische Börse BitBank mit Sanktionen wegen angeblicher Bitcoin-Transfers der IRGC
- Sep 21, 2026 at 04:05 am
- Das US-Finanzministerium hat die iranische Krypto-Börse BitBank sanktioniert und behauptet, sie sei an der Weiterleitung von Bitcoin an die IRGC beteiligt gewesen. Diese Maßnahme zieht die Schlinge um die digitale Asset-Infrastruktur Irans enger.
-
- Krypto-Kreuzung: Beste Krypto zum Kauf inmitten der SEC-Regulierung und dem Aufstieg von Pepeto
- Sep 21, 2026 at 04:05 am
- Inmitten der sich weiterentwickelnden SEC-Vorschriften erweist sich ein neuer Player, Pepeto, als potenziell „beste Kryptowährung zum Kaufen“, der innovative Tools und Frühbuchermöglichkeiten bietet und im Gegensatz zu etablierten Giganten und schwindenden Meme-Coins steht.
-
- Bitcoin-Preis: Der spektakuläre Aufschwung und sein Scheideweg
- Sep 21, 2026 at 03:55 am
- Bitcoin erlebte einen spektakulären Aufschwung und stieg auf über 80.000 US-Dollar, stößt jedoch aufgrund geopolitischer Gegenwinde und eines sich abkühlenden technischen Signals auf einen kritischen Widerstand bei 82.000 US-Dollar. Kann es sich behaupten?
-
- Ein Angreifer, mehrere Token: Einblick in die Fetch.ai-Sicherheitslücke – Eine New Yorker Minute
- Sep 20, 2026 at 08:05 pm
- Der Verstoß gegen Fetch.ai, bei dem es sich zunächst um einen FET-Token-Diebstahl im Wert von 1,5 Millionen US-Dollar handelte, hat sich zu einer Multi-Token-Saga mit NTX, AGIX und WMTX ausgeweitet, wobei die Gesamtbestände der Angreifer mittlerweile 17 Millionen US-Dollar übersteigen. Dieser Vorfall verdeutlicht den entscheidenden Unterschied zwischen gestohlenen und neu geprägten Token und offenbart tiefere Auswirkungen auf die Sicherheit, die über die anfänglichen finanziellen Verluste hinausgehen.
-
- MultiversX stoppt Mainnet: Aufklärung des Vorfalls „Invalid State“.
- Sep 20, 2026 at 08:05 pm
- MultiversX hat kürzlich sein Mainnet angehalten, weil ein Angreifer einen Atomizitätsfehler ausnutzte, der zu einem „ungültigen Zustand“ führte und einen komplexen Wiederherstellungsaufwand auslöste, um die Netzwerkintegrität und das Vertrauen der Benutzer sicherzustellen.
-
- Bitcoin, Altcoins und Kryptowährung: Ein Marktschub, der durch Regulierung und Innovation angetrieben wird, nicht nur durch Memes
- Sep 20, 2026 at 08:05 pm
- Der unerwartete Sprung von Bitcoin über 80.000 US-Dollar löste eine breitere Krypto-Rallye aus, die durch kluge Regulierungsmaßnahmen und eine deutliche Verlagerung hin zu Altcoins mit echten Nutzen- und Einnahmequellen angeheizt wurde. Dies ist nicht mehr der Kryptomarkt Ihrer Oma.


